Faut-il bloquer les crawlers IA sur mon site ? Les bons réglages
Nous venons de voir des bots IA explorer notre site pour la première fois. Faut-il les bloquer ?
Faut-il bloquer les crawlers IA sur mon site ? Pour la plupart des PME, non. Bloquez les URL qui font travailler votre serveur, pas les bots capables de vous faire apparaître dans les réponses de ChatGPT, Claude et Perplexity. Quand des crawlers IA ont poussé notre propre serveur à 100 % de CPU, un seul bot a déclenché 1 073 régénérations d’une même page en 23 heures. Nous l’avons quand même laissé passer.
Pourquoi les crawlers IA apparaissent soudain dans vos rapports
Beaucoup de dirigeants, d’un cabinet dentaire à Zurich à un bureau d’architectes à Lausanne, découvrent seulement maintenant ces visiteurs. Le rapport LLM bot insights de Webflow montre quels bots IA visitent un site et quelles pages ils demandent, à partir des journaux du serveur (les logs). Il faut un forfait Team ou Enterprise avec le module complémentaire Analyze.
Le rapport classe les bots en quatre groupes : les bots agentiques, qui récupèrent une page pour répondre à la question d’un utilisateur, les bots d’entraînement, les bots d’indexation, et les bots à usages multiples comme Googlebot et Bingbot. Un détail vous évitera un e-mail inquiet. /manifest.json figure souvent parmi les chemins les plus visités : selon Webflow, c’est normal et sans lien avec votre contenu. Le rapport ne dit pas non plus si une page a été citée dans une réponse d’IA. Il montre seulement qu’un bot l’a demandée.
Tous les crawlers IA ne font pas le même travail
« Crawler IA » recouvre trois types de visiteurs, et chacun a sa propre règle dans le robots.txt, le simple fichier texte qui indique aux bots ce qu’ils ont le droit de lire. OpenAI précise que chaque réglage est indépendant. Vous pouvez autoriser son bot de recherche pour apparaître dans les résultats tout en bloquant son bot d’entraînement.
| Type de bot | Exemples | Ce qu’il fait | Ce que change le blocage |
|---|---|---|---|
| Recherche et indexation | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Trouve les pages à afficher et à citer en lien dans les réponses de la recherche IA | OpenAI : votre site n’apparaît plus dans les réponses de ChatGPT search, même s’il peut encore s’afficher comme lien de navigation. Anthropic : votre contenu n’est pas indexé pour la recherche de Claude. |
| Déclenché par l’utilisateur | ChatGPT-User, Claude-User, Perplexity-User | Récupère une page quand une personne pose une question | Anthropic : Claude ne peut pas récupérer votre page pour cet utilisateur. OpenAI et Perplexity indiquent que les règles du robots.txt peuvent ne pas s’appliquer, puisque c’est une personne qui a lancé la requête. |
| Entraînement | GPTBot, ClaudeBot, Google-Extended | Collecte du contenu susceptible d’entraîner de futurs modèles d’IA | Indique que vos futurs contenus doivent être exclus de l’entraînement. Cela ne vous retire pas de la recherche. |
La page d’aide d’Anthropic donne la même répartition pour ses trois bots et précise qu’ils respectent le robots.txt. Selon Perplexity, PerplexityBot ne sert pas à entraîner des modèles de fondation, et l’éditeur recommande de l’autoriser. Google-Extended est un cas à part. Il n’a pas de user agent propre et contrôle uniquement l’usage que Google peut faire du contenu pour Gemini. Google indique qu’il n’a aucun effet sur la présence dans la recherche Google et qu’il ne compte pas comme signal de positionnement.
Quand autoriser les crawlers IA
Autorisez les bots de recherche et ceux déclenchés par l’utilisateur si vous voulez être cité dans les réponses des assistants IA. Ce sont eux qui lisent votre page quand quelqu’un demande à ChatGPT ou à Perplexity une recommandation dans votre domaine. Bloquez-les, et vous disparaissez de cette réponse. Si vous ne savez pas où vous en êtes aujourd’hui, commencez par vérifier si ChatGPT recommande déjà votre entreprise.
Autorisez-les aussi si vos pages sont des pages commerciales : services, tarifs, équipe, études de cas. Ces pages existent pour être lues. C’est le choix que nous avons fait pour notre propre site. Notre robots.txt dit toujours oui à la recherche, aux réponses IA et à l’entraînement IA, parce que nous voulons que ChatGPT, Claude et Perplexity lisent nos pages et nous citent.
Quand bloquer, et quoi exactement
Bloquez les bots d’entraînement si votre contenu est ce que vous vendez, par exemple des guides payants ou des études, et que vous ne voulez pas qu’il serve à construire des modèles d’IA. Les règles étant indépendantes, bloquer GPTBot ou Google-Extended ne vous retire ni de ChatGPT search ni de la recherche Google.
Bloquez les variantes d’URL qui font travailler le serveur sans rien ajouter au contenu. Les liens de filtres, de tags et de numéros de page peuvent transformer une seule page en centaines d’adresses. Un crawler qui les suit toutes ne fait rien de mal, mais votre serveur paie chaque visite.
Ralentissez un bot trop gourmand avant de lui fermer la porte. Anthropic prend en charge la règle Crawl-delay pour ClaudeBot. Dans les documentations que nous avons lues, c’est le seul fournisseur à la mentionner.
Évitez le blocage par adresse IP. Anthropic prévient que cette méthode peut ne pas fonctionner comme refus, car le bot ne peut plus lire votre robots.txt. Les noms de user agent peuvent aussi être usurpés, comme le rappelle Google : un bot qui se présente comme GPTBot n’est donc pas forcément OpenAI. Si vous utilisez Cloudflare, Perplexity signale que le Bot Fight Mode peut quand même soumettre ses bots à un challenge, et recommande des règles de pare-feu qui vérifient à la fois le user agent et l’IP. Les changements ne sont pas instantanés non plus. OpenAI et Perplexity parlent tous deux d’environ 24 heures.
Ce qui s’est passé quand des crawlers IA ont surchargé notre serveur
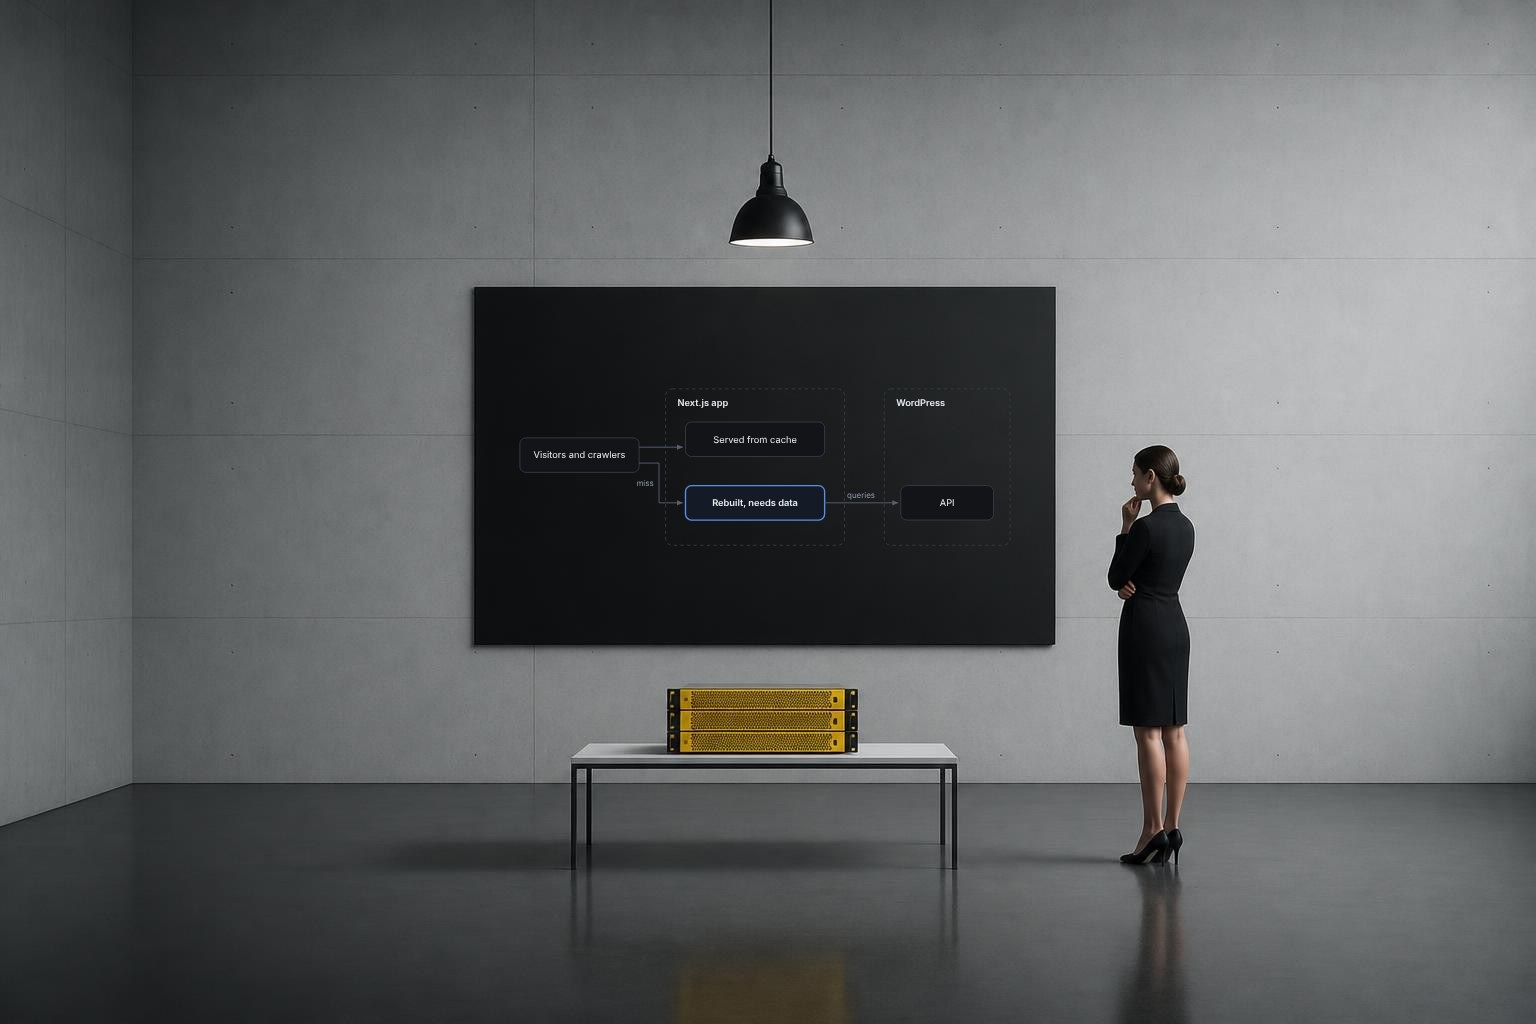
Ce mois-ci, notre serveur WordPress a atteint 100 % de CPU à plusieurs reprises, une fois pendant 40 minutes. Notre hébergeur voyait environ 2 400 requêtes par jour et soupçonnait un script. Les logs ont montré autre chose : l’essentiel de la charge venait des crawlers IA. En 23 heures, la liste de notre blog a été régénérée 1 344 fois, dont 1 073 fois pour ClaudeBot. Il suivait chaque lien ?page= et ?tag=, et notre site reconstruisait la page à chaque visite.
Nous n’avons pas bloqué les bots IA. Nous avons seulement bloqué les variantes ?page= et ?tag=, et imposé à ClaudeBot un délai d’exploration de 10 secondes. Les moteurs de recherche trouvent toujours chaque article grâce au sitemap. Nous gardons aussi un fichier llms.txt qui présente notre studio aux outils d’IA et renvoie vers nos pages principales. Avec quatre autres petites corrections, voici le résultat :
| Indicateur | Avant | Après |
|---|---|---|
| Requêtes par jour | 2 400+ | 176 |
| Saturations du CPU | Répétées, dont une de 40 minutes à 100 % | Disparues |
| Bots IA autorisés pour la recherche, les réponses et l’entraînement | Oui | Oui |
Faut-il bloquer les crawlers IA sur mon site ? Le contrôle en cinq étapes
- Ouvrez votre rapport de bots et listez les pages que les bots IA demandent le plus. Dans Webflow : Insights, Site overview, onglet AI discovery, LLM bots.
- Vérifiez si ces pages sont mises en cache ou régénérées à chaque visite.
- Bloquez les variantes d’URL inutiles (filtres, tags, numéros de page) avant d’envisager de bloquer un bot.
- Tranchez la question de l’entraînement IA séparément de celle de la recherche et des réponses, puisque chacune a sa propre règle.
- Si un bot reste trop lourd, ralentissez-le avec Crawl-delay quand le fournisseur le permet, ou écrivez au fournisseur depuis une adresse de votre domaine, comme le demande Anthropic.
La plupart de ces décisions se prennent pendant la création du site, pas dans l’urgence après une alerte serveur. Un site conçu pour la recherche à l’ère de l’IA est livré avec un robots.txt propre, un sitemap, des pages en cache et un fichier llms.txt, et quelqu’un vérifie les rapports de bots après la mise en ligne. Notre guide de stratégie SEO, GEO et AEO (le référencement naturel sur Google, puis l’optimisation pour les moteurs génératifs et pour les moteurs de réponse, afin que les assistants IA vous citent) montre où se place l’accès des crawlers. Pour savoir où en est votre site, lancez l’audit gratuit de Pixerry. Il lit votre site comme le font les moteurs de recherche et les moteurs d’IA.