Serveur WordPress à 100 % CPU : ce n’était pas une attaque
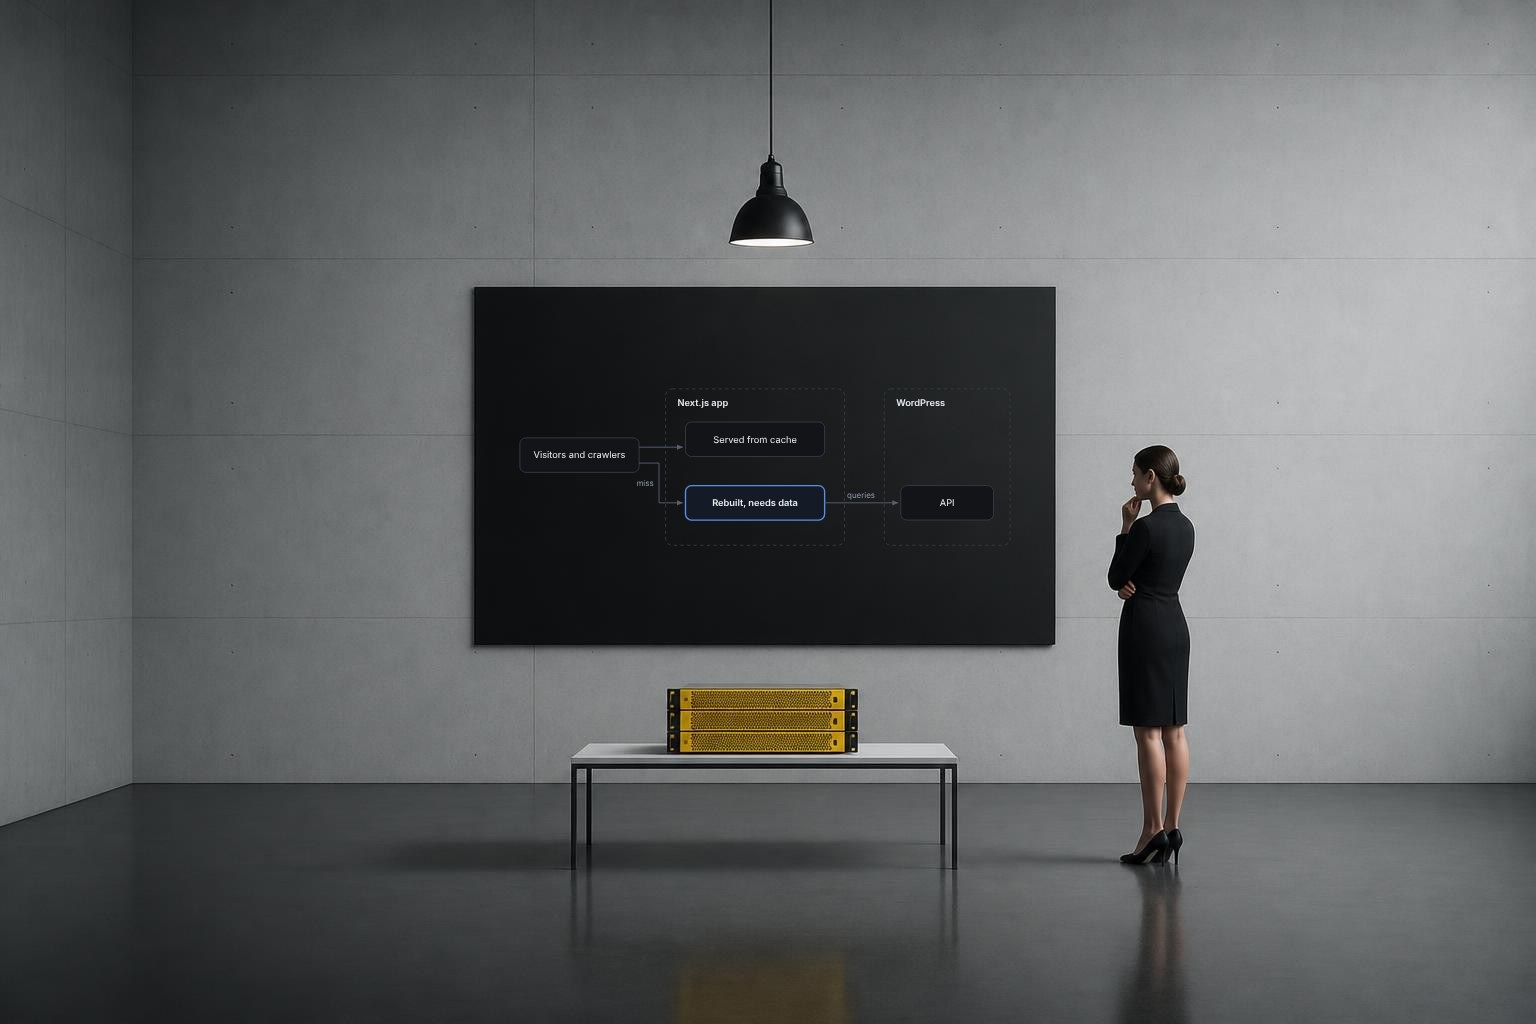
Notre serveur WordPress atteignait sans cesse sa limite : 100 % de CPU. La cause ne venait pas d’une attaque, mais de notre propre site web. Des robots d’exploration (crawlers) visitaient surtout une page : la liste de notre blog. Notre site reconstruisait en partie cette page à chaque visite, et chaque reconstruction envoyait de nouvelles requêtes à WordPress.
Tout a commencé par un message de notre hébergeur. Il voyait environ 2 400 requêtes par jour, venant de plusieurs adresses IP de cloud américaines, avec l’user agent node. Selon lui, un script ou une boucle d’interrogation (polling) en était la cause. Un soir, le CPU est resté à 100 % pendant 40 minutes.
Voici comment nous avons trouvé la cause, ce que nous avons changé, et une checklist pour votre propre site WordPress headless.
La configuration : qui interroge WordPress
Notre site est headless : WordPress ne fait que stocker le contenu. Une application Next.js, chez un autre hébergeur, construit les pages que voient les visiteurs.
- Le site web lit le contenu via WPGraphQL, en trois langues (EN, FR, RU).
- Les visiteurs et les robots ne se connectent jamais directement à WordPress. Le serveur leur envoie les pages et sert la plupart d’entre elles depuis son cache.
Ce dernier point compte. Quand le serveur reconstruit une page, il redemande les données à WordPress. Chaque page vue qui n’est pas en cache donne donc du travail à WordPress.
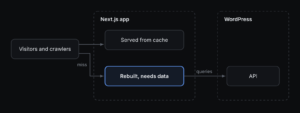
Notre site reconstruisait la liste du blog à chaque visite, parce que sa pagination passait par des paramètres d’URL. Un cache existait dès le départ, mais Next.js ne mettait en cache que les pages, pas leurs variantes avec paramètres. Chaque passage d’un crawler sur cette page faisait donc travailler WordPress.
Ce que montraient les logs
L’user agent node a été le premier indice. Next.js envoie cet user agent quand il récupère des données côté serveur. Les adresses IP de cloud américaines correspondaient à la région par défaut de notre plateforme d’hébergement. Les requêtes venaient donc de notre propre application. Restait à savoir pourquoi elle interrogeait WordPress aussi souvent.
Les logs de requêtes de notre plateforme d’hébergement ont donné la réponse. Nous avons exporté 23 heures de logs avec son outil en ligne de commande. Puis nous avons compté les pages que la plateforme reconstruisait au lieu de les servir depuis son cache.
| Page | Reconstructions en 23 h | Visiteur principal |
|---|---|---|
/blog (les 3 langues) | 1 344 | ClaudeBot (1 073), puis MJ12bot, PetalBot, etc. |
/works | environ 90 | mixte |
| Tout le reste | presque toujours en cache | — |
Les logs d’erreurs et l’historique des déploiements ont apporté deux autres constats :
- Des scanners demandaient des chemins comme
/.envet/ads.txt. Notre page d’accueil lisait.envcomme un code de langue et envoyait une requête à WordPress avec. Résultat : une 404. - Les builds coïncidaient avec la pire soirée. Notre plateforme d’hébergement a lancé six builds complets en 40 minutes. Chaque build récupérait toutes les pages dans les trois langues.
L’historique sur 30 jours de notre hébergeur a fourni un dernier indice. Les deux pires jours, nous n’avions presque rien déployé. Les builds causaient des pics courts, mais la charge constante venait des crawlers.
Pourquoi notre serveur WordPress est monté à 100 % de CPU
Aucun bug isolé n’explique ce problème. Quatre choix tout à fait courants se sont additionnés.
- Une page n’était jamais mise en cache. La liste de notre blog lit
?page=et?tag=dans l’URL. Next.js refait donc le rendu de la page à chaque requête. Un crawler qui essaie toutes les combinaisons de pages et de tags la reconstruit un grand nombre de fois. Chaque reconstruction comptait aussi tous les articles, six par six, uniquement pour afficher les numéros de page. - Les données expiraient toutes les heures. Nous mettions en cache toutes les requêtes WordPress pendant une heure. Entre deux passages de crawler, le cache avait souvent expiré. La reconstruction interrogeait donc de nouveau WordPress.
- Chaque mise en production construisait le site trois fois. Notre plateforme d’hébergement créait une copie complète à chaque étape de notre processus de relecture.
- WordPress ne mettait pas les requêtes en cache. WPGraphQL Smart Cache était installé. Mais son cache objet, la partie compatible avec nos requêtes POST, était désactivé. Chaque requête faisait donc tourner PHP et la base de données en entier.
Les points 1 et 4 n’avaient rien de nouveau : ils existaient depuis plus d’un an. C’est le trafic qui a changé. Les crawlers d’IA passent désormais beaucoup plus souvent, et notre robots.txt les autorisait.
Ce que nous avons changé
Nous avons fait cinq petits changements. Aucun n’a demandé de nouvelle infrastructure.
| Changement | Où | Effet |
|---|---|---|
Interdire ?page= et ?tag= dans robots.txt, Crawl-delay: 10 pour les robots | Next.js | Les crawlers ne visitent plus les variantes d’URL sans cache. Les moteurs de recherche trouvent toujours les articles via le sitemap.xml |
| Mettre en cache les données WordPress 24 heures au lieu d’une heure | Next.js | Chaque page récupère de nouvelles données WordPress au plus une fois par jour |
| Renvoyer une 404 pour les codes de langue inconnus, avant toute requête | Next.js | Les URL des scanners, comme /.env, n’atteignent plus WordPress |
| Ne construire que la production, un build à la fois | Réglages de l’hébergement | Un seul build par mise en production, au lieu de trois en même temps |
| Activer le cache objet de Smart Cache, 24 heures | Réglages WordPress | Les requêtes répétées, y compris la plupart de celles d’un build, ne sollicitent pas la base de données |
Le premier changement a fait effet en une nuit. Les reconstructions de la liste du blog par ClaudeBot sont passées d’environ 84 toutes les deux heures à zéro.
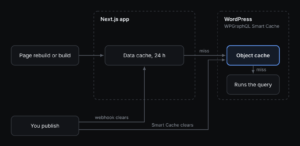
Une requête n’atteint la base de données que si aucun des deux caches n’a la réponse. Une publication vide les deux caches : le nouveau contenu apparaît en quelques secondes.
Résultats
Au bout de cinq jours, WordPress recevait 176 requêtes GraphQL par jour. C’est plus de 90 % de moins qu’avant, et le serveur n’a plus dépassé sa limite de CPU.
| Mesure | Avant | 4 nov. | 5 nov. | 6 nov. | 7 nov. | 8 nov. |
|---|---|---|---|---|---|---|
| Requêtes GraphQL vers WordPress | 2 400 à 2 900 | — | 1 196 | 334 | 335 | 176 |
| Dépassements de la limite CPU | la plupart des jours | quelques-uns | plusieurs | quelques-uns | quelques-uns | aucun |
| Builds de production | 3 par mise en production | 2 | 5 | 0 | 1 | 0 |
| Reconstructions de la liste du blog | environ 1 300 | 268 | 43 | 81 | 59 | 42 |
| Visites de ClaudeBot sur la liste du blog | 1 073 | 4 | — | 0 | 0 | 0 |
Chaque colonne couvre 24 heures à partir de 9 h environ, heure de Paris. Un tiret signifie que nous n’avons pas de chiffre pour ce jour-là. Le 6 nov., plus de la moitié des requêtes venaient de notre propre travail de développement.
Les derniers dépassements sont arrivés par courtes rafales. Chaque build de production récupère tout le site d’un coup. Les jours où nous codons, notre travail de développement ajoute des requêtes. Notre dernier correctif était un réglage WordPress : le cache objet de Smart Cache. Il garde les réponses assez longtemps pour couvrir l’intervalle entre deux mises en production. Le 8 nov., nous n’avons rien mis en production : notre prochain build montrera le résultat.
Prochaine étape : la liste du blog (pas encore terminée)
Cette partie est encore en cours. La liste du blog renvoie toujours vers ses propres variantes : le HTML de /blog contient 11 liens comme ?page=2 et ?tag=seo. Les crawlers suivent chaque lien, et une seule page devient des dizaines d’URL. Un sitemap n’y change rien, car les crawlers suivent d’abord les liens. Notre règle robots.txt arrête les crawlers qui la respectent, mais elle ne règle pas la cause.
Nous publions environ deux articles par semaine : chaque langue comptera environ 100 articles d’ici un an. La solution doit tenir à cette échelle. Nous comparons trois options :
| Option | Fonctionnement | Pour | Contre |
|---|---|---|---|
| Tous les articles sur une page | La page de liste contient tous les articles. Les numéros de page et les tags filtrent dans le navigateur | Simple. Une seule page statique. Aucune variante d’URL | La page s’alourdit à partir de 100 articles |
| Pages dans le chemin de l’URL | /blog/page/2, /blog/tag/seo. Chaque page est statique et ne contient que ses propres articles | Tient jusqu’à des centaines d’articles. De vraies URL que les moteurs de recherche peuvent indexer | Plus de routes. Les anciens liens ?page= demandent des redirections |
| Rendu partiel (Next.js 16) | Une coquille de page statique. La partie liste est mise en cache pour chaque page et chaque tag | Petite modification du code de la page | Demande une mise à jour majeure de Next.js. Les crawlers suivent toujours chaque lien ?page= |
Aucune de ces options ne nous convient encore tout à fait : chacune règle une partie du problème et ajoute un nouveau coût. Nous continuons donc à chercher, et nous ajouterons le résultat ici.
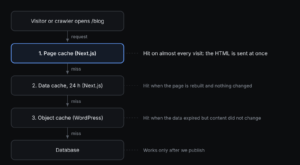
Quel que soit notre choix, l’objectif reste le même : une visite normale s’arrête au cache des pages, et la base de données ne travaille qu’après une publication. Publier vide les trois caches, donc les nouveaux articles apparaissent toujours en quelques secondes.
WordPress à 100 % de CPU, que faire ? La checklist pour un site headless
Votre hébergeur WordPress signale un trafic GraphQL important ? Vérifiez ces points avant de passer à une offre supérieure.
- Identifiez qui envoie les requêtes. Un user agent
nodedésigne votre propre frontend. Un nom de robot signifie que le robot appelle WordPress directement. - Repérez les pages jamais mises en cache. Dans les logs de votre hébergement, cherchez les routes qui affichent toujours
MISS. Ce sont en général des pages qui lisent des paramètres de recherche. - Regardez qui visite ces pages. Si ce sont surtout des crawlers, bloquez les variantes d’URL dans
robots.txt. Ne bloquez pas la page entière. - Gardez votre cache plus longtemps. Mettez en cache les données WordPress pendant une journée. Utilisez un webhook pour le rafraîchir à chaque publication. Ne récupérez pas de nouvelles données toutes les heures.
- Comptez vos builds. Chaque build de prévisualisation récupère tout votre site. Si vous n’utilisez pas les prévisualisations, ne construisez que la production.
- Activez le cache objet. Dans WPGraphQL Smart Cache, cochez Use Object Cache. Passez l’expiration de 10 minutes (valeur par défaut) à 24 heures ou plus. Ce cache fonctionne avec les requêtes POST et se vide tout seul quand vous publiez.
- Rejetez tôt les URL parasites. Avant d’interroger WordPress, renvoyez une 404 pour toute URL qui ne correspond pas à une vraie route.
- Maîtrisez les URL de filtres et de pagination. Donnez aux pages et aux filtres de vraies URL que l’on peut mettre en cache, ou retirez-les des liens. Sinon, une seule page de liste devient des dizaines d’URL pour les crawlers.