Automatisation IA hébergée en Europe : une PME doit-elle garder ses agents sur ses propres serveurs ?
Dans la plupart des cas, non. Le bon critère est la nature des données que l’agent voit, pas l’adresse du serveur. Même en mode « auto-hébergé », les agents managés lancés par Mistral le 5 novembre 2026 laissent Mistral stocker les sessions.
Garder l’IA chez vous se justifie quand l’agent touche des données sensibles ou prépare des décisions sur des personnes. Dans les autres cas, une séparation stricte des données et une validation humaine protègent mieux qu’un serveur dans vos locaux.
Ce que Mistral a lancé le 5 novembre 2026
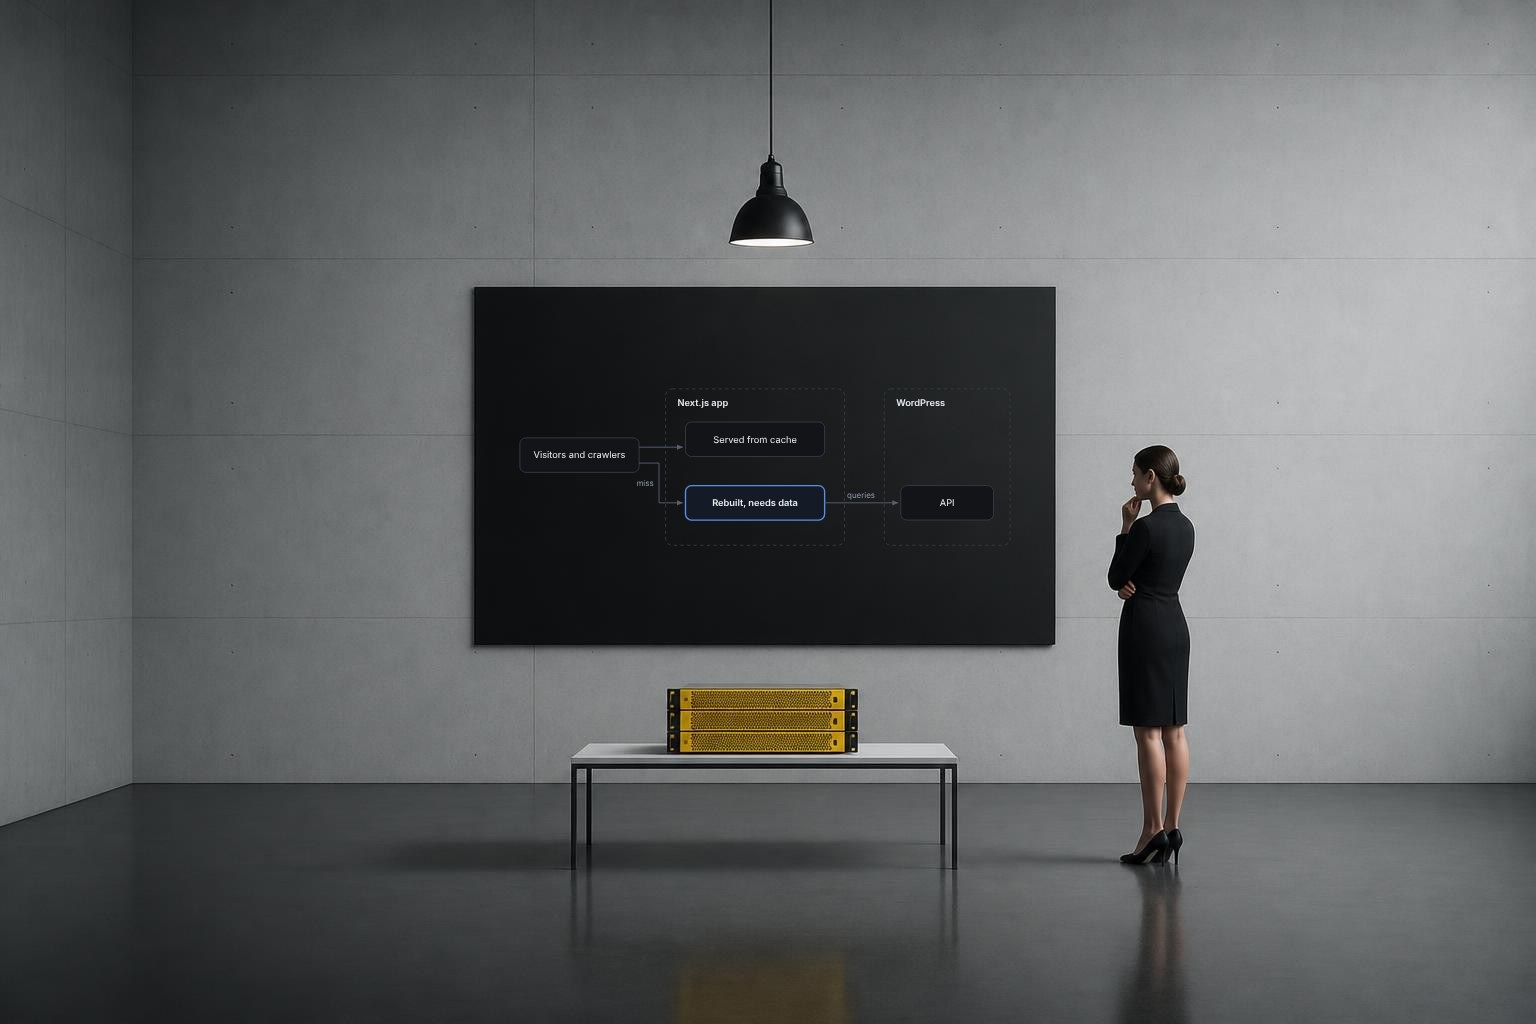
Mistral, l’entreprise française d’IA, a élargi Studio, sa plateforme pour entreprises. Studio accueille désormais des agents managés, des applications et des workflows reliés aux données et aux outils d’une entreprise. Selon l’annonce de Mistral, ils peuvent être déployés « dans le cloud, dans votre propre VPC, sur site ou dans une combinaison de ces environnements ». Un VPC est un réseau privé isolé chez un hébergeur cloud.
Pour une PME, le point le plus utile est ailleurs : les étapes de validation humaine. Le client décide quelles actions exigent l’accord d’une personne. Mistral cite un agent d’analyse d’incidents qui suit la procédure de l’équipe et demande une validation avant toute action sensible.
Trois façons de faire tourner un agent
La documentation des agents Mistral décrit trois modes d’exécution. Le tableau montre ce qui reste chez vous dans chacun.
| Mode | Ce qui tourne chez vous | Sessions | Usage prévu par Mistral |
|---|---|---|---|
| Dans votre propre processus | L’agent, en local | Gardées en mémoire | Développement |
| Auto-hébergé (agents serve) | L’agent et ses outils, sur vos serveurs | Stockées par Mistral | Production avec des outils qui doivent rester dans votre réseau |
| Géré par Mistral (agents deploy) | Rien | Stockées par Mistral | Aucun hébergement de votre côté |
Le modèle, lui, tourne sur l’API de Mistral ou derrière votre propre passerelle. Une demande de validation attend une réponse pendant une heure par défaut, même si votre application est fermée. La réponse peut venir de votre code ou d’une personne.
Ce qui n’est pas encore disponible
Les agents managés sont en préversion publique : leur API, leur comportement et leurs limites peuvent changer, et une mise à jour peut demander de modifier le code. Dans les notes de version du 5 novembre, chaque nouveauté porte l’étiquette « Mistral-Hosted ». Les versions cloud privé et sur site sont annoncées, sans date officielle sur les pages que nous avons lues. En novembre 2026, Mistral ne publie aucun prix pour ces modes de déploiement.
Quand garder ses agents sur ses propres serveurs
L’auto-hébergement se justifie dans quelques situations précises.
- L’agent traite vos processus les plus sensibles. BNP Paribas explique faire tourner Studio sur sa propre infrastructure pour cette raison.
- L’agent prépare des décisions sur des clients ou des candidats, par exemple un refus de dossier.
- Vos outils internes ne doivent pas sortir de votre réseau. C’est le cas d’usage que Mistral donne au mode auto-hébergé.
- Un client ou votre secteur vous impose de garder les données dans votre périmètre.
La CNIL recommande de privilégier « des systèmes locaux, sécurisés et spécialisés ». À défaut, elle demande de vérifier dans quelle mesure le fournisseur peut réutiliser les données confiées, puis d’adapter l’usage.
Le coût caché, c’est l’exploitation. Un serveur sur site demande quelqu’un pour l’installer, le mettre à jour et le surveiller. Dans une petite équipe, cette personne est souvent le dirigeant lui-même.
Quand un service cloud suffit
Une grande partie des automatisations d’une PME produit des brouillons, trie des demandes ou résume des échanges. C’est le cas d’un chatbot de service client ou d’un site Webflow relié à n8n qui route les demandes entrantes. Si l’agent ne voit pas de données personnelles et qu’une personne relit chaque sortie, un cloud géré convient.
Parmi les règles d’usage proposées, la CNIL cite justement deux interdits : ne pas confier de données personnelles au système et ne pas lui confier de décisions. Si votre automatisation respecte ces deux règles, la question de l’hébergement devient secondaire.
Notre cas : une IA qui travaille sur le brief, pas sur la personne
Sur notre page contact, l’ancien formulaire a disparu. À sa place, Pixi, un agent IA conçu par Olga, fondatrice de Pixerry, aide les visiteurs à décrire leur projet. Sa première règle : l’IA travaille sur le brief, pas sur la personne.
Nous avons donc séparé les données. Pixi ne reçoit que les questions et réponses sur le projet : objectif, budget, délai, site actuel. Le nom, l’e-mail, l’entreprise et le téléphone passent par un formulaire séparé, à la fin. Ce formulaire contourne l’IA et arrive directement à Olga par notre propre automatisation. Les données personnelles n’atteignent jamais l’IA. Elles ne peuvent donc pas finir dans l’entraînement d’un modèle.
Pixi ne repose pas sur un modèle auto-hébergé. Les réponses sur le projet passent par l’API professionnelle d’Anthropic, dont les conditions interdisent à Anthropic d’entraîner ses modèles sur ce contenu. Nous ne stockons pas les adresses IP des visiteurs, seulement une version brouillée à sens unique pour limiter l’usage.
Le dispositif suit aussi l’AI Act. Son article 50 s’applique depuis le 2 août 2026 : une personne doit être informée quand elle échange directement avec une IA. Pixi l’annonce sur le bouton et dans son premier message. La prise de rendez-vous et l’e-mail restent visibles en permanence : un humain est toujours à un geste. Pixi ne décide rien sur personne. Il rédige le brief, Olga lit chacun et répond elle-même. Le visiteur peut modifier le brief, rien n’arrive avant qu’il clique sur Envoyer, et la case de consentement n’est jamais pré-cochée.
Pour un client aux règles plus strictes, nous pouvons aller plus loin. Une fois les versions cloud privé et sur site de Mistral disponibles, le même type d’assistant pourra garder tout dans l’infrastructure du client, avec une personne qui valide chaque étape sensible.
Quatre questions avant de choisir l’hébergement
- Quelles données l’agent verra-t-il ? Listez-les champ par champ et retirez du flux celles dont il n’a pas besoin.
- L’agent décide-t-il quelque chose pour quelqu’un ? Si oui, placez une validation humaine avant l’action.
- Le fournisseur peut-il réutiliser vos données ? Lisez ses conditions d’API avant de lui confier quoi que ce soit.
- Qui maintiendra un serveur sur site ? Sans réponse claire, un cloud avec données réduites et validations humaines vaut mieux qu’une installation que personne ne surveille.
| Situation | Choix raisonnable |
|---|---|
| Brouillons, tri, synthèses sans données personnelles | Cloud géré, relecture humaine des sorties |
| Données clients utiles, mais aucune décision automatique | Cloud avec données réduites et conditions vérifiées, ou VPC |
| Décisions sur des personnes, processus sensibles, outils internes | Auto-hébergé ou sur site, validation humaine sur chaque action sensible |
Quand nous concevons une automatisation IA pour une PME, nous partons de cette liste de données. Le choix d’hébergement vient ensuite. Première étape de votre côté : prenez le processus que vous voulez automatiser et notez les informations personnelles que l’IA n’a pas besoin de voir.