Блокировать ИИ-краулеры на сайте? Что разрешить, а что закрыть
Мы впервые увидели, что ИИ-боты обходят наш сайт. Их нужно блокировать?
Малому бизнесу в большинстве случаев не нужно. Блокировать ИИ-краулеры на сайте целиком не стоит. Закрывайте URL, которые нагружают сервер, а не ботов, благодаря которым вы попадаете в ответы ChatGPT, Claude и Perplexity. Когда ИИ-краулеры загрузили процессор нашего собственного сервера на 100%, один бот за 23 часа вызвал 1073 пересборки одной и той же страницы. Мы всё равно оставили его открытым.
Почему ИИ-краулеры вдруг появились в ваших отчётах
Многие владельцы бизнеса, от стоматологии в Лимассоле до архитектурного бюро в Никосии, только сейчас замечают таких посетителей. Отчёт Webflow LLM bot insights показывает, какие ИИ-боты заходят на сайт и какие страницы запрашивают. Данные берутся из серверных логов сайта. Для отчёта нужен тариф Team или Enterprise с дополнением Analyze.
Отчёт делит ботов на четыре группы. Агентные боты открывают страницу, чтобы ответить на вопрос пользователя. Есть боты для обучения, боты для индексации и многоцелевые боты вроде Googlebot и Bingbot. Одна деталь сэкономит вам тревожное письмо. Путь /manifest.json часто оказывается среди самых посещаемых, и Webflow пишет, что это нормально и к вашему контенту не относится. А вот процитировали ли страницу в ответе нейросети, отчёт не покажет. Он показывает только, что бот её запросил.
Какие бывают ИИ-краулеры и чем они отличаются
Под словом «ИИ-краулер» скрываются три разных типа посетителей, и для каждого в robots.txt пишется своё правило. robots.txt — простой текстовый файл, который говорит ботам, что им можно читать. OpenAI указывает, что все настройки независимы. Можно разрешить поискового бота, чтобы появляться в результатах, и при этом закрыть бота для обучения.
| Тип бота | Примеры | Что делает | Что значит блокировка |
|---|---|---|---|
| Поиск и индексация | OAI-SearchBot, Claude-SearchBot, PerplexityBot | Находит страницы, которые показываются со ссылкой в ответах поиска в нейросетях | OpenAI: сайт не показывается в ответах поиска ChatGPT, хотя может появиться как навигационная ссылка. Anthropic: контент не индексируется для поиска Claude. |
| По запросу пользователя | ChatGPT-User, Claude-User, Perplexity-User | Открывает страницу, когда человек задаёт вопрос | Anthropic: Claude не сможет получить вашу страницу для этого пользователя. OpenAI и Perplexity говорят, что правила robots.txt могут не действовать, потому что запрос запустил человек. |
| Обучение | GPTBot, ClaudeBot, Google-Extended | Собирает контент, на котором могут обучаться будущие модели ИИ | Сигнал, что ваш будущий контент не нужно использовать для обучения. Из поиска вас это не убирает. |
Справка Anthropic описывает такое же деление для трёх своих ботов и подтверждает, что они соблюдают robots.txt. Perplexity пишет, что PerplexityBot не используется для обучения базовых моделей, и советует его разрешать. Google-Extended — особый случай. У него нет собственного user agent, он только определяет, как Google может использовать контент для Gemini. По словам Google, он не влияет на попадание в Google Search и на позиции в поиске.
Когда ИИ-краулеры стоит разрешить
Разрешайте поисковых ботов и ботов по запросу пользователя, если хотите, чтобы нейросети называли вас в ответах. Именно они читают вашу страницу, когда кто-то просит ChatGPT или Perplexity посоветовать компанию в вашей сфере. Заблокируете их, и вы выпадете из ответа. Если не знаете, как обстоят дела сейчас, начните с проверки, советует ли ChatGPT ваш бизнес уже сегодня.
Разрешайте их и в том случае, если ваши страницы маркетинговые: услуги, цены, команда, кейсы. Такие страницы для того и существуют, чтобы их читали. Для своего сайта мы решили именно так. Наш robots.txt по-прежнему разрешает поиск, ответы нейросетей и обучение ИИ: мы хотим, чтобы ChatGPT, Claude и Perplexity читали наши страницы и ссылались на нас.
Когда блокировать и что именно закрывать в robots.txt
Закрывайте ботов для обучения, если ваш контент и есть продукт, например платные гайды или исследования, и вы не хотите, чтобы на нём строили модели ИИ. Правила независимы, поэтому блокировка GPTBot или Google-Extended не убирает вас ни из поиска ChatGPT, ни из Google Search.
Закрывайте варианты URL, которые нагружают сервер, но не добавляют контента. Ссылки фильтров, тегов и номеров страниц способны превратить одну страницу в сотни адресов. Краулер, который проходит по всем, ничего не нарушает. Но за каждый визит платит ваш сервер.
Прежде чем закрыть тяжёлого бота, попробуйте его притормозить. Anthropic поддерживает для ClaudeBot правило Crawl-delay. Из всей документации, которую мы прочитали, его упоминает только этот провайдер.
Не блокируйте ботов по IP-адресу. Anthropic предупреждает, что такой отказ может не сработать: бот больше не сможет прочитать ваш robots.txt. К тому же имена user agent можно подделать, на что указывает Google. Бот, который называет себя GPTBot, не обязательно принадлежит OpenAI. Если вы пользуетесь Cloudflare, учтите: по словам Perplexity, Bot Fight Mode всё равно может выдавать её ботам проверку. Поэтому Perplexity рекомендует правила файрвола, которые учитывают и user agent, и IP. Изменения тоже вступают в силу не сразу. OpenAI и Perplexity называют срок около 24 часов.
Что произошло, когда ИИ-краулеры перегрузили наш сервер
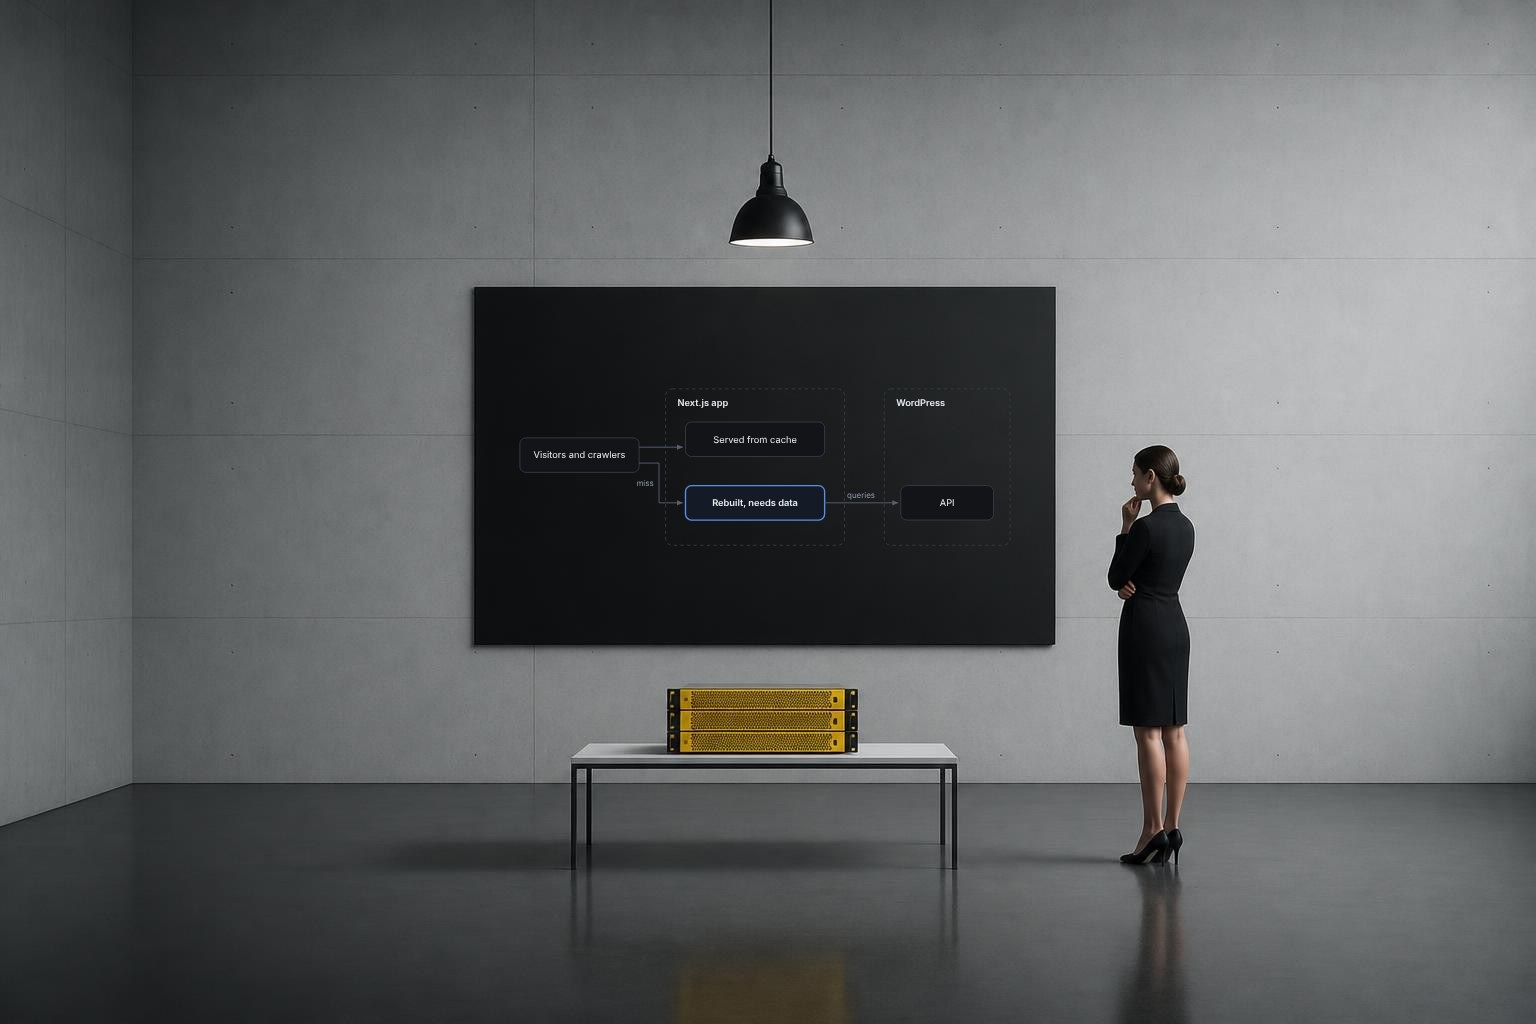
В этом месяце наш сервер на WordPress раз за разом упирался в 100% нагрузки на процессор, однажды на 40 минут. Хостинг видел около 2400 запросов в день и подозревал какой-то скрипт. Логи показали другое: большую часть нагрузки давали ИИ-краулеры. За 23 часа список статей нашего блога пересобирался 1344 раза, и 1073 из них пришлись на ClaudeBot. Он проходил по каждой ссылке ?page= и ?tag=, а сайт заново собирал страницу при каждом визите.
ИИ-ботов мы не блокировали. Закрыли только варианты ?page= и ?tag= и задали ClaudeBot задержку обхода в 10 секунд. Поисковики по-прежнему находят каждую статью через sitemap. Ещё у нас есть файл llms.txt: он рассказывает ИИ-инструментам, кто мы, и ведёт на наши основные страницы. Вместе с четырьмя другими небольшими исправлениями результат получился такой:
| Показатель | До | После |
|---|---|---|
| Запросов в день | 2400+ | 176 |
| Сбои CPU | Повторялись, однажды 40 минут на 100% | Прекратились |
| ИИ-боты разрешены для поиска, ответов и обучения | Да | Да |
Нужно ли блокировать ИИ-краулеры на сайте: проверка в пять шагов
- Откройте отчёт по ботам и выпишите страницы, которые ИИ-боты запрашивают чаще всего. В Webflow: Insights, Site overview, вкладка AI discovery, LLM bots.
- Проверьте, кешируются ли эти страницы или собираются заново при каждом визите.
- Закройте мусорные варианты URL, такие как фильтры, теги и номера страниц, прежде чем думать о блокировке бота.
- Решение об обучении ИИ принимайте отдельно от поиска и ответов: у каждого из них своё правило.
- Если какой-то бот всё ещё слишком нагружает сервер, замедлите его через Crawl-delay, где провайдер это поддерживает. Или напишите провайдеру с адреса на вашем домене, как просит Anthropic.
Большинство этих решений принимают на этапе разработки, а не в панике после тревоги с сервера. Сайт, сделанный под поиск в эпоху нейросетей, запускается с чистым robots.txt, sitemap, кешированными страницами и файлом llms.txt, а после запуска кто-то следит за отчётами по ботам. Наше руководство по стратегии SEO, GEO и AEO (SEO — поисковое продвижение, GEO — оптимизация под нейросети, AEO — чтобы ИИ цитировал сайт в ответах) показывает, какое место здесь занимает доступ краулеров. Pixerry — европейская студия, говорим по-русски. Чтобы понять, в каком состоянии ваш сайт, пройдите нашу бесплатную проверку сайта. Она читает сайт так, как его видят поисковики и нейросети.